Altman cuestiona la IA en la PC: memoria escasa y un debate entre eficiencia y privacidad
El titular de OpenAI dice que usar modelos en computadoras personales desaprovecha una memoria DRAM que hoy cuesta cada vez más. Quienes defienden la IA local responden con la privacidad.
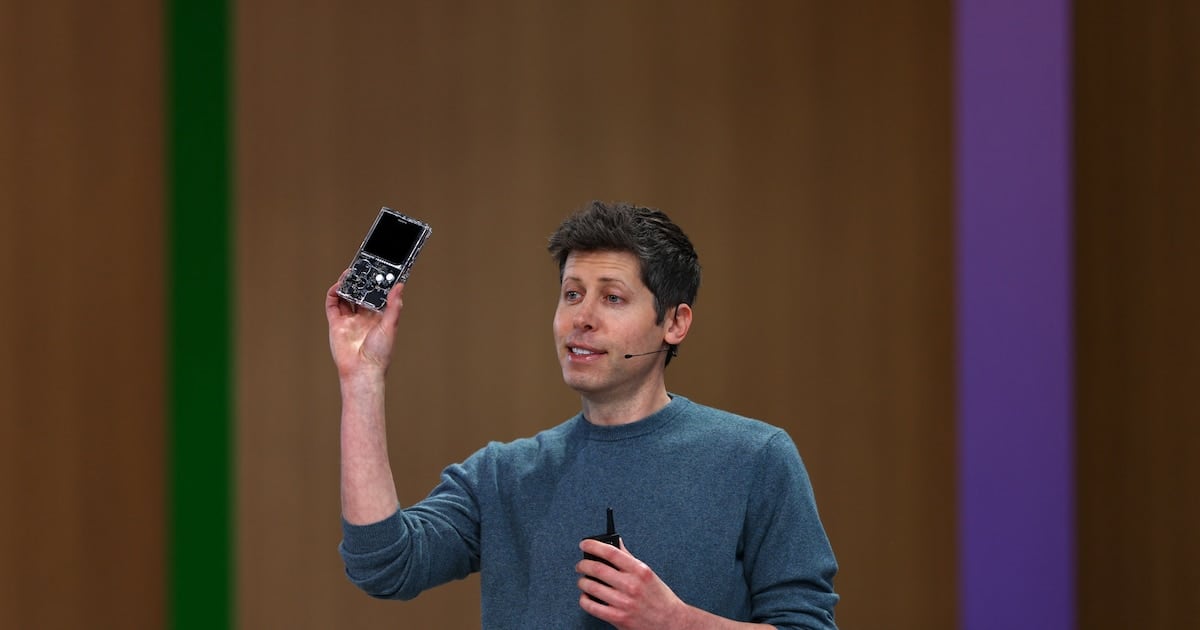
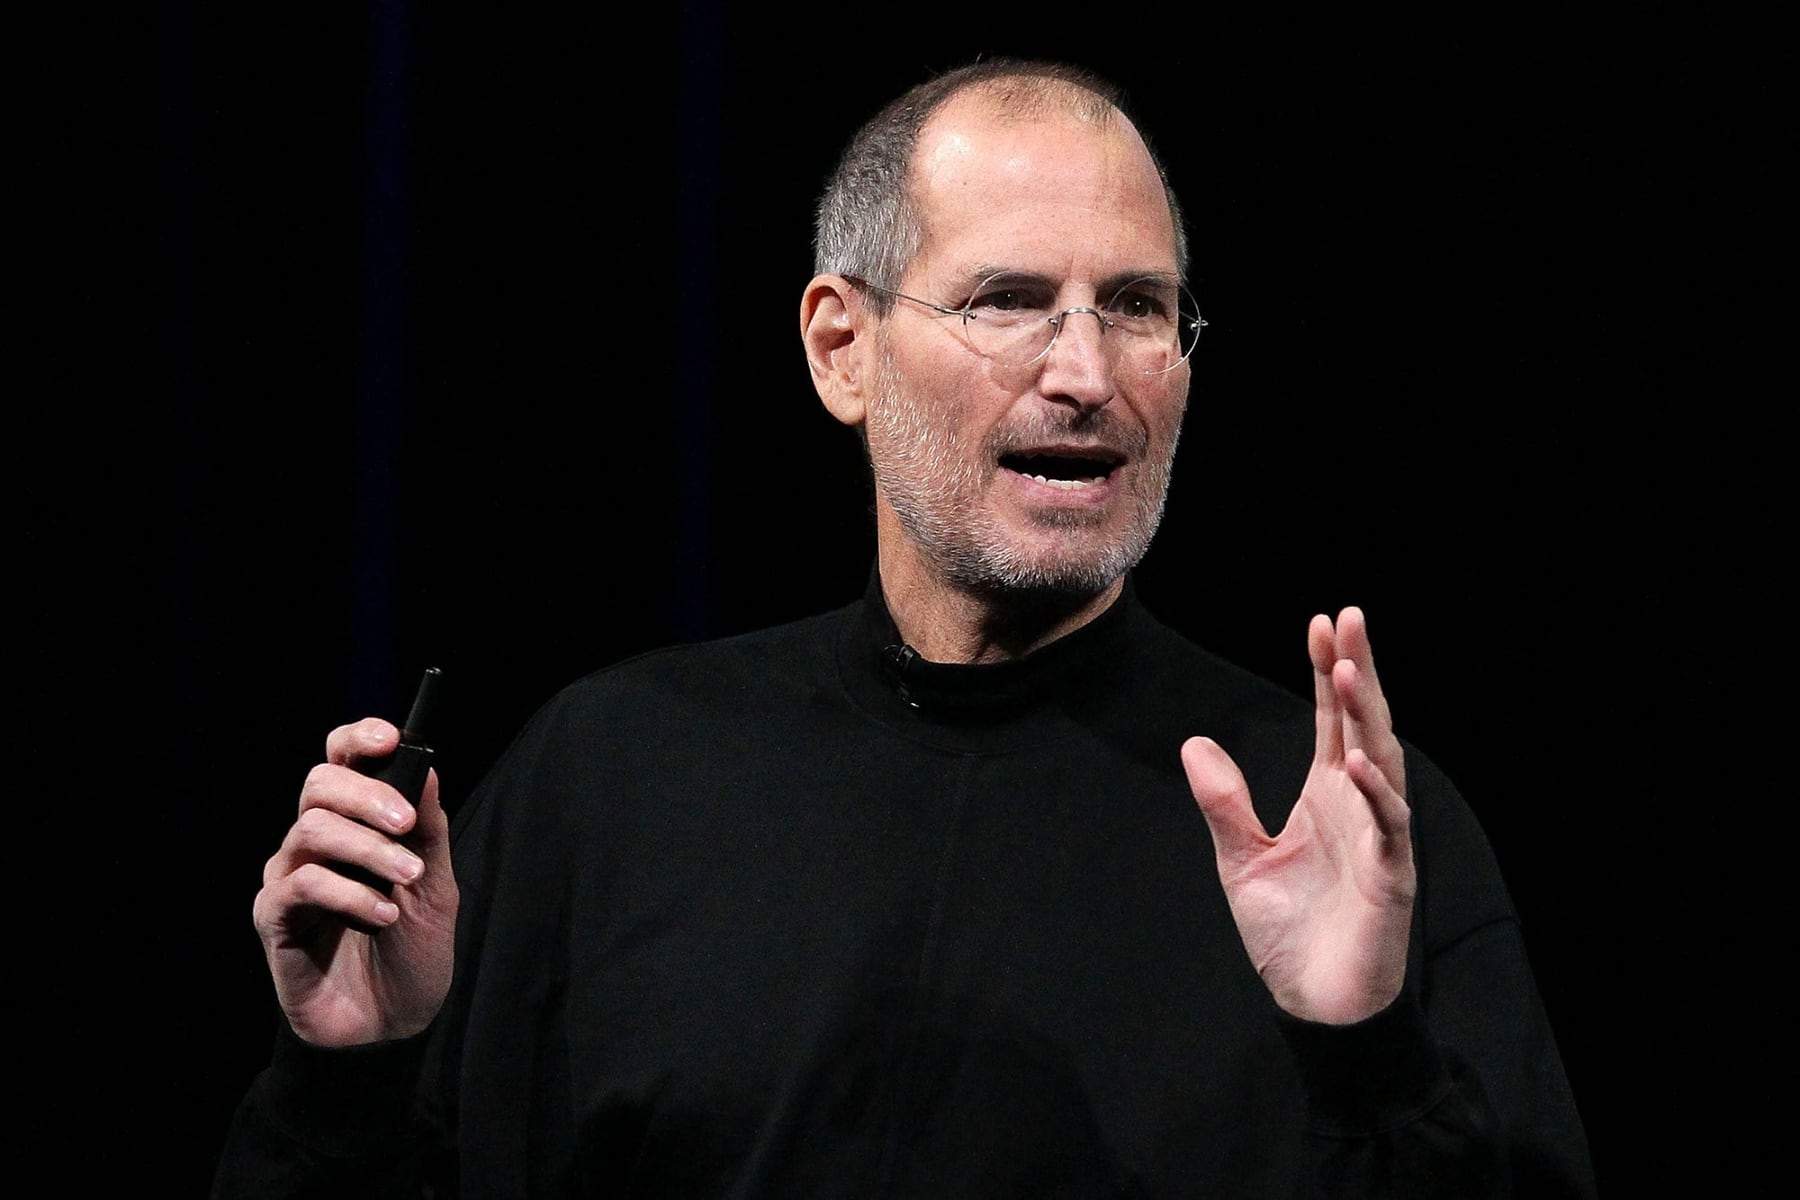
Sam Altman, director ejecutivo de OpenAI, sostiene que correr modelos de inteligencia artificial directamente en computadoras domésticas es una mala forma de usar la memoria DRAM. El argumento llega en un momento en que ese componente está caro y escasea a nivel global.
Una memoria que duerme casi todo el día
La memoria instalada en una PC permanece inactiva la mayor parte del tiempo. Altman cifró ese uso efectivo en un 5% y lo presentó como un problema de asignación de recursos. Lo dijo en una entrevista en el pódcast Cheeky Pint, conducido por John Collison, cofundador de Stripe.
“La inferencia local es una terrible asignación de recursos escasos.”Sam Altman
La inferencia local es, en criollo, usar el modelo en tu propia máquina en lugar de mandar la consulta a un servidor remoto. Es como cocinar en casa en vez de pedir delivery: lo hacés vos, con tus ingredientes, pero necesitás tener la cocina equipada.
El dato que respalda parte del diagnóstico
Según TrendForce, los precios de la DRAM subieron entre un 90% y un 95% durante el primer trimestre de 2026. Fabricantes como Micron y SK Hynix no logran escalar la producción al ritmo que piden los grandes operadores de centros de datos dedicados a IA.
- Varias compañías redirigieron capacidad de fabricación hacia memoria HBM, la de alto rendimiento que requiere esa infraestructura.
- Ampliar plantas especializadas toma más de un trimestre.
- Del lado de quienes defienden la IA local, el argumento central es la privacidad: procesar datos sin enviarlos a servidores externos.
La discusión queda así planteada entre dos lógicas: la eficiencia de concentrar la memoria en la nube y el control de los datos que ofrece correr los modelos en el propio equipo.